一、引子:当「思考」比电费还便宜
先讲一个容易被忽略的对照。
2020 年,你要用 GPT-3 处理一百万个 token,大约要花 60 美元。到 2026 年,同样一档「够用」的智能,每百万 token 的输入价格已经跌到 6 美分上下——同样一笔钱,五年前只能买大约一万多 token 的思考,今天能买下一百亿 token。
这不是某一家厂商的降价促销,而是一条全行业、跨厂商、跨开源闭源的共同曲线。研究机构 Epoch AI 在 2026 年 9 月的报告《The Plunging Price of Thought》里给出了一个更狠的判断:自 2023 年以来,实现同等智能水平的成本大约每季度下降 47%,折算每年约 13 倍;并且强调,AI 变便宜的速度,比历史上任何一项颠覆性技术都快——是 DNA 测序速度的四倍、摩尔定律下算力降价速度的六倍、锂电池降价速度的十八倍(Epoch AI)。
换句话说:智能,正在以人类工业史上前所未有的速度,从奢侈品变成日用品。
这篇文章想回答的,不是「降价了多少」这个已经被反复说过的事实,而是接下来三件更重要的事:
- 这条曲线是怎么被压出来的,它的尽头在哪里;
- 为什么智能越便宜,电反而越贵——硅基文明的物理天花板在哪里;
- 当思考像水电一样按量计费,个人、创业者、整个产业的账本会被怎么重写。
二、一张图看懂「价格坍塌」
先把最硬的事实摆上桌。下图是 2020 到 2026 年,两档代表性模型的输入价格(每百万 token,美元,对数坐标):
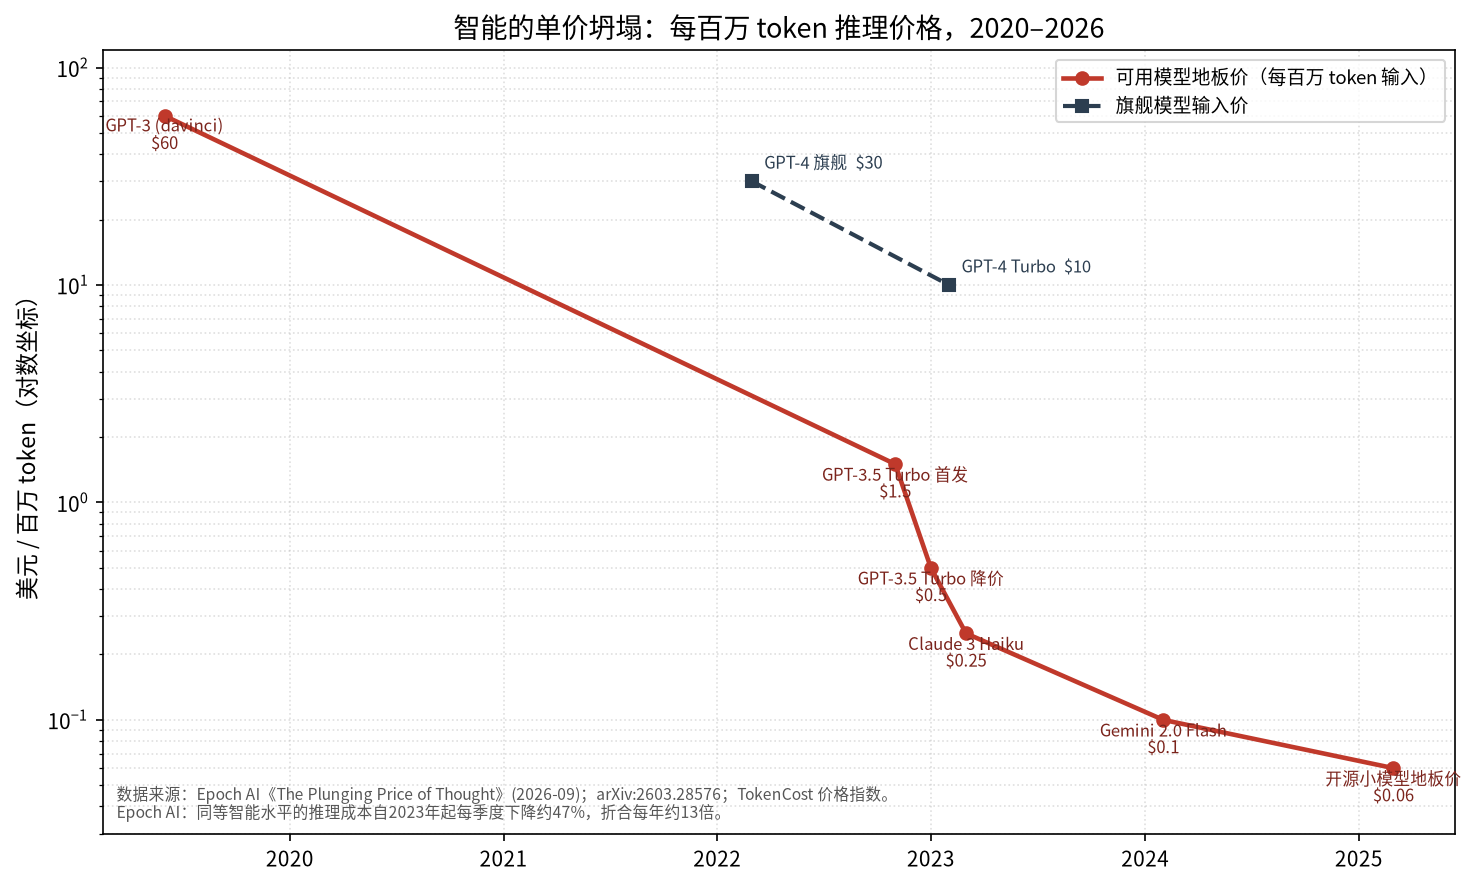
图1|每百万 token 推理价格的对数坐标坍塌曲线。数据来源:Epoch AI、arXiv:2603.28576、TokenCost 价格指数。
几个关键刻度:
- 2020 年 6 月,GPT-3(davinci):约 60 美元/百万 token。 这是「买智能」的初代标价(arXiv:2603.28576)。
- 2023 年 3 月,GPT-4 旗舰:30 美元/百万 token 输入。 旗舰智能第一次被明码标价,贵得让人倒吸一口凉气。
- 2024 年初,GPT-3.5 Turbo 被砍到 0.50 美元/百万 token 输入——相较其 2023 年首发价便宜了约 75%;同年 3 月 Claude 3 Haiku 把入门档压到 0.25 美元(TokenCost 价格指数)。
- 2025 年初,Gemini 2.0 Flash 把地板价打到 0.10 美元/百万 token(arXiv:2603.28576)。
- 2026 年第一季度,全行业中位价已跌破 0.50 美元/百万 token,开源小模型(如 LLaMA 3.2 3B 一类)的落地价探到 0.06 美元(bibliotekanauki.pl 实证研究)。
把这些点连起来看,会发现一个反直觉的事实:这条曲线不是平滑下降的,而是一级一级往下跳的台阶。Nesyona Research 跟踪 12 个前沿模型、33 个版本后测算,按「完成同一任务的成本」从峰值到地板约下降了 530 倍,而每一次台阶都由新一代模型或新的架构触发(Nesyona)。
600 倍不是修辞,是可以被一行行 API 账单复核的。
三、坍塌的三股动力:谁在把价格往下砸
价格不会自己塌。背后是三股力量同时做功。
第一股:算法效率。 MoE(混合专家)架构让模型只激活一小部分参数就能出活;投机解码(speculative decoding)用小模型起草、大模型校验,把吞吐成倍拉高;更长的上下文配合 KV cache 复用,让重复计算被大幅摊薄。换句话说,单位智能所消耗的算力本身在变少。
第二股:硬件与工程。 更快的芯片、更成熟的推理框架(vLLM 一类)、更极致的批处理(batching),把单卡的产出往上抬。这部分在我们站点另一篇 vLLM 开源推理 与 推理成本曲线 里有更细的工程拆解,这里只点一句:工程优化本身就是降价的主引擎之一。
第三股,也是最关键的一股:开源。 只要存在一个免费或极便宜的开源可用模型,闭源旗舰就永远不敢把价格定高。这就是为什么 2024 年之后,每一次价格战的导火索几乎都来自开源阵营——DeepSeek 们用「够用且便宜」的现实,逼着整个市场重写价签。你可以在站点的 OpenAI vs DeepSeek 2026 一文中看到这场价格拉锯的全景。
三股力量叠加的结果,就是 Epoch AI 那个「每季度 -47%」的陡峭斜率。
值得单独说一句的,是开源这股力量的「鲶鱼效应」。闭源厂商之间的降价是有底线的——大家心照不宣地维持高价,谁先降谁先受伤。但开源模型把这条底线一脚踢翻:当 LLaMA、DeepSeek、Qwen 这些权重可以被免费下载、自行部署,闭源 API 就永远无法再回到「按旗舰利润定价」的旧时光。于是你会看到一个奇怪的现象:真正推动降价的,往往不是某家厂商发善心,而是开源阵营先把「够用的智能」免费化了,闭源不得不跟进。 这也是为什么国产开源模型在这场价格战里扮演了「价格屠夫」的角色——它不是在卖模型,它是在给整个行业设定价格上限。
再往深看一层,这种降价还有一个结构性加速器:推理成本里有很大一块是「固定成本被摊薄」。一座 GPU 集群一旦建好,每多服务一个请求,边际成本就下降一点;请求量越大,单位成本越低。这跟电网的逻辑完全一致——电厂建好了,多供一户电的边际成本趋近于零。所以只要需求在涨,成本就会被持续摊薄,形成「降价→需求更旺→规模更大→成本更低→再降价」的正反馈螺旋。理解了这个螺旋,就理解了为什么这条曲线短期内停不下来。
四、价格门槛,每隔一段就催生一个新品类
经济学里有个朴素道理:价格落到某个阈值以下,原本「算不过账」的生意就突然成立了。对推理成本的实证研究恰好识别出三个关键门槛——每百万 token 约 2 美元、0.10 美元、0.06 美元——每跨过一道,就冒出一批全新的产品形态(bibliotekanauki.pl):
- 2 美元档:文档自动化、企业聊天机器人成立,AI 第一次在客服、归档等场景跑通 ROI;
- 0.10 美元档:多模态分析、实时语音、批量内容生成变得划算,「到处都塞一个 Agent」从烧钱变成可计费;
- 0.06 美元档:7×24 小时常驻 Agent、对成本极度敏感的长尾应用(个人助理、批量处理、游戏 NPC 动态剧情)开始成立。
这解释了为什么 2025–2026 年「Agent 经济体」突然爆发——不是大家突然想通了,而是价格终于跌到了「让一个 Agent 全天干活也不心疼」的水平。站点的 Agent 经济体 一文记录了这场变现浪潮;而 LLM token 价格基准 则从 CFO 视角给出了这笔账的另一面。
价格是需求的总开关。 开关每往下拨一档,被点亮的应用版图就扩大一圈。
举个最直观的例子:在每百万 token 还要几十美元的年代,让 AI「通读一整份合同并逐条批注」是一件算不过账的奢侈事;而当单价跌到几美分,同样的动作不仅便宜,还能 7×24 小时对成千上万份合同同时做。成本的微小下降,乘以「被它解锁的应用数量」,放大出来的是一个量级的市场。这也是为什么聪明人从来不盯着模型榜单上的分数,而是盯着价格曲线——分数决定上限,价格决定规模。 上限再高,用不起也只是实验室里的玩具;价格一旦到位,玩具就会在一夜之间变成基础设施。
五、反面:智能越便宜,电反而越贵
但故事到这里有一个巨大的、也是最「硅基」的反转:单价的暴跌,刺激了用量的爆炸,而用量爆炸最终撞上的是物理世界的电网。
这就是经典的「杰文斯悖论」——蒸汽机越省煤,煤的总消耗反而越高。智能也一样:调用越便宜,人就越什么都让它调用。于是单价在跳水,总用电量在飙升。
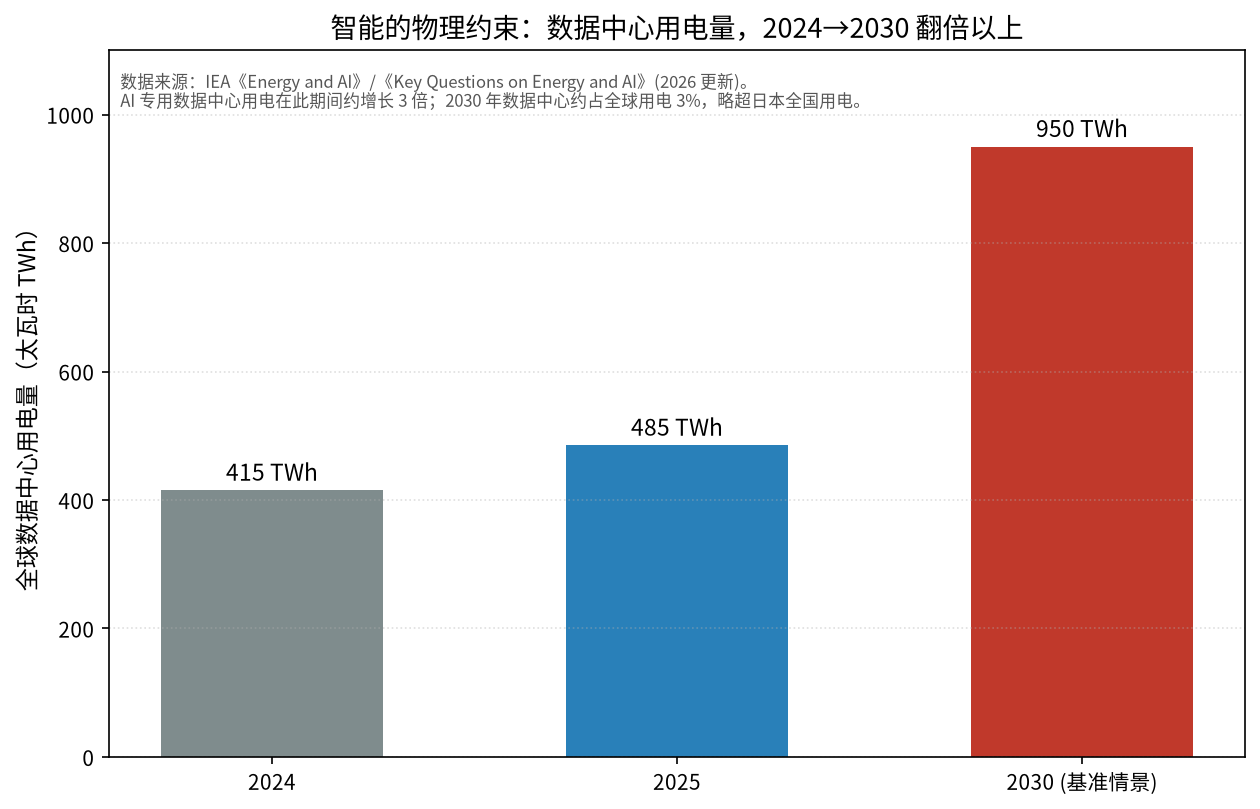
图2|全球数据中心用电量:2024 约 415 TWh,2025 约 485 TWh,2030 基准情景约 950 TWh。数据来源:IEA《Energy and AI》。
国际能源署(IEA)的最新测算给出了这条物理曲线:
- 全球数据中心用电量将从 2025 年约 485 TWh,上升到 2030 年约 950 TWh,翻倍以上;
- 其中 AI 专用数据中心在此期间约增长 3 倍,是增长的绝对主力;
- 到 2030 年,数据中心约占全球用电量的 3%——略多于今天日本全国的总用电量(IEA 执行摘要、IEA 人工智能专题)。
看清楚这个对称:软件侧的成本在以每年 13 倍的速度坍塌,硬件侧的电力需求却在以五年翻倍的速度膨胀。 一个向下、一个向上,两条曲线迟早要在某个点上正面相撞。
这就是为什么我说硅基文明进入了「电价时代」——未来的稀缺资源不再是「你能不能买到智能」,而是「你的智能背后,有没有足够的电、足够的散热、足够的变压器,按期把机柜点亮」。关于这一点,站点的 AI 数据中心:电力、芯片与地缘政治 有更系统的展开。
用量到底爆炸到什么程度?看一个真实样本。 据站点此前报道,某大型金融集团的智能体平台,日均 token 消耗量已经达到约 1200 亿——这是一个单一企业、单一平台的数字。把它乘以全国、再乘以全球数百万个正在把 AI 塞进工作流的组织,你就能理解为什么 IEA 要把 AI 专用数据中心的用电增长预期直接上调到「三倍」。token 单价在跳水,token 总消耗量在以更陡的斜率爬升,两个数相乘,才是真实的能耗账单。
这也正是「杰文斯悖论」在智能时代的完美复刻:十九世纪,瓦特改良蒸汽机让煤的利用效率大幅提升,结果英国的煤炭总消耗不降反升;今天,每百万 token 的价格跌了 600 倍,结果人类消耗的智能总量,正以远超 600 倍的速度膨胀。省下来的每一毛钱,都被用得更狠了。 智能的需求曲线,远比人们想象的陡峭。
六、商业后果:从「卖模型」到「卖智能当量」
理解了上面两条曲线,就能看懂当下所有大公司在赌什么。
当模型本身的价格向零收敛,「卖模型」这件事的毛利就会被快速抹平——就像今天没人会为一度电的「品牌」多付多少钱,电就是电,大家只看电表数。未来的模型也会大宗商品化。
那钱去哪了?去了三个地方:
- 智能当量的抽成权。像电网一样,谁建了最大的「智能电厂」、谁能以最低的稳定成本供电,谁就能在每一度被消费的「智能」里抽成。OpenAI 被传寻求 1.2 万亿美元 Pre-IPO 估值(站点相关报道),市场买的根本不是今年的 API 利润,而是这个「未来电网」的长期过路费。
- 围绕模型的搬不走的东西:私有数据、工作流、分发渠道、信任关系、合规资质。模型是水管,水龙头后面接的是别人的厨房。
- 电力与基础设施。谁锁定了电源、土地、散热和先进封装产能,谁就卡住了智能的物理上限——这也是为什么芯片、HBM、CoWoS 封装集体涨价(站点快讯里已有大量记录)。
一句话:模型会变成水和电,而「水厂」「电网」「电工」会成为新的权力阶层。
这里可以做一个历史类比。十九世纪末,工厂主普遍自备蒸汽机自行发电——「自发电」就像今天的「自建大模型」。但当电网建成、电价跌到比自发电还便宜之后,没有任何一家工厂会继续养着自己的蒸汽机,大家都去接电网、看电表。今天的大模型正在重演这一幕:只有少数真正有海量私有数据、对延迟和合规极度敏感的组织,才值得「自发电」(自建/私有化部署);绝大多数应用,最终都会选择「接电网」(调 API)。 这正是为什么「本地部署 vs 云端 API」会成为一个持续被讨论的决策题——本质上,就是在算「自发电」和「接电网」哪个更划算。而随着电价(推理单价)不断下行,天平会越来越快地倒向「接电网」。
七、对个人与创业者:真正稀缺的东西变了
如果你是开发者或创业者,这一节直接关系到你的账本。
当「调用智能」不再花什么钱,过去因为「算力太贵」而做不了的应用,现在全都敞开了。但与此同时,过去靠「我接了个厉害模型」建立的微弱优势,也一夜之间蒸发了——你的竞争对手和你调用的是同一个、甚至更便宜的模型。
所以真正的稀缺项变成了:
- 判断力:知道把智能用在哪个真问题上,比会用智能重要一百倍;
- 私有数据与反馈闭环:模型是公共的,你的场景数据是私有的;
- 分发与信任:用户凭什么用你的,而不是直接去问 ChatGPT;
- 成本结构设计:会用「小模型干小事、大模型干难事」的分级路由,才能在价格战里活到最后。
这也是为什么「一人公司」叙事在 2026 年看起来既真实又脆弱——真实在于智能成本确实塌了,脆弱在于门槛低意味着谁都能进,护城河只能从「人手」转移到「判断力 + 分发 + 数据」。站点大量关于 AI 副业、独立 SaaS 的快讯,背后都是这个逻辑的不同切面。
如果要把这个判断落成几条可执行的建议,我会给开发者三句话:
第一,把模型当水电,别当资产。 不要在「锁定某个模型 API」上建立产品,因为这个成本今天可能是你的优势,明天就会变成所有人的基线。真正要沉淀的是你的数据、你的工作流、你的用户关系。
第二,学会用「混合路由」过日子。 简单分类、摘要、改写交给便宜的小模型或开源模型;只有在真正难、真正值钱的环节,才调用旗舰大模型。这种「能省则省、该花才花」的分级策略,是价格战时代的生存基本功——也是成本优化类工具在 2026 年突然走红的根本原因。
第三,把力气花在「智能够不到」的地方。 当生成文本、图片、代码都变得免费,人的价值就往两端迁移:一端是定义问题(判断力),另一端是建立信任与分发(渠道、品牌、线下关系)。中间那层「用 AI 批量产出平庸内容」的活,会是最先被抹平利润的部分。
八、风险与泡沫:方向是真的,价格是贵的
最后必须泼一盆冷水。
「智能水电化」这个方向,我认为是真的——历史上每一种重大成本向零收敛的技术(电力、互联网带宽、智能手机算力),最终都重塑了社会。但「方向是真的」不代表「今天的估值是合理的」。
这里有三个悬而未决的风险:
- 电力天花板。如果 950 TWh 的用电增长真的撞上电网建设周期、变压器产能与气候约束,智能的「供水能力」可能被物理世界卡住,价格曲线未必能一直这么顺滑地降下去。
- 开源围剿。只要开源模型继续以免费或极低价逼近旗舰,闭源厂商的抽成空间就会被反复挤压——这是价格战本身的产物。
- 资本预期。1.2 万亿美元级别的估值,定价的是「智能成为第四种公用事业」的完美剧本;一旦增长、电力或变现任何一环不及预期,估值的回撤会同样剧烈。
这里还藏着一个更隐蔽的风险:价格战本身可能反噬安全投入。 当推理单价被压到极致,厂商为了维持毛利,会在推理配置、冗余、安全护栏上一压再压——而这些恰恰是防止模型越界、防止被滥用的成本。也就是说,「智能越便宜」和「智能越不安全」可能是同一枚硬币的两面。这也是为什么监管(比如欧盟 AI 法案)要强制 AI 生成内容标注、强制聊天机器人亮明身份——因为当智能的供给成本趋近于零,滥用的成本也趋近于零,社会必须用规则给这个「免费」加上边界。
还有一个容易被乐观情绪掩盖的事实:降价不是匀速的。 这条曲线是一级一级跳的台阶,而非平滑下滑。它依赖于一代又一代新架构、新硬件、新开源模型的持续供给。一旦某一代模型的进步放缓,或电力瓶颈让「多供电」变得困难,价格曲线就可能在某个平台期停滞——那时,今天所有按「永远更便宜」做的商业假设,都会重新承压。
我的判断很简单:这件事的方向是真的,但今天为它支付的价格是贵的。 对使用者是黄金时代,对盲目追高者是高危时刻。
九、结语:我们正站在「电价时代」的门口
把这篇文章压缩成三句话:
- 同等智能的成本每季度降约 47%,单价五年塌了约 600 倍——智能正在像水电一样成为公用事业;
- 但单价越便宜,总用电越爆炸,2030 年数据中心用电将翻倍到约 950 TWh——硅基文明的下一道边界是电网,不是算法;
- 模型会大宗商品化,未来的权力属于「智能电厂」、「电网」与掌握私有数据和分发的人——智能当量的抽成权,就是新时代的地租。
给这个「电价时代」留一句可以被记住的话:
当思考的价格跌到接近零,真正昂贵的就不再是智能本身,而是「把它用在对的地方」的判断力,以及「让它持续有电可用」的物理世界。
我们不是在见证一次降价促销。我们是在见证一种新基础设施的诞生——就像一百年前城市里亮起第一盏由统一电网供电的灯。只不过这一次,被点亮的不是街道,是思考本身。
最后值得停下来想一秒的,是这件事的历史位置。人类文明的每一次跃升,本质上都是把某种昂贵的东西变得便宜:把食物变便宜,养活了更多人;把动力变便宜,开启了工业;把信息变便宜,开启了互联网;而现在,正在变便宜的是思考本身。当思考不再稀缺,稀缺的就不再是「想得出来」,而是「想得对不对、用在何处、为谁所用」。这或许是「智能水电化」留给这个时代最深刻的一句话:机器负责把思考的价格打到零,人负责守住思考的方向。 电价时代的真正分野,从来不在于你接不接得到电网,而在于你拿这免费的一度电,去点亮什么。