一、引子:当 AI 不再只会「接话」,开始「脑补」物理世界
先把镜头拉回 2026 年 9 月 7 日晚上的一段视频。
场地中央站着一台宇树 G1 人形机器人。对面是一个人类拳手。人出拳,机器人双拳收到胸前「咚」地挡住;一记鞭腿扫过来,它退后半步,稳住重心,回身还了一拳。画面角落打了四个字:全程实拍,无加速。场地里没有遥控器,没有 VR 头显,没有隐藏在幕布后的远程操作员。
这不是又一段「机器人跳舞」的花絮。宇树科技在视频里把它定义为:全球首次由世界模型实时驱动的全自主人形机器人搏击(环球网、中国新闻网)。
七天之后,9 月 10 日,宇树又把背后的大脑 UnifoLM-WLA-1.0 完全开源。半个多月前,9 月 1 日,李飞飞的 World Labs 发布了被称为「全球首个多模态世界模型」的 Atlas;又过了不到一个月,AMD 宣布以约 82 亿美元把这家公司收归囊中(界面新闻)。
把这几件事排在一起看,你会发现它们指向同一个拐点:AI 正在从一个「只会用文字接话」的系统,变成一个「能在脑内想象物理世界会怎么演变」的系统。 而这件事一旦成立,最先被改写的就是机器人——那个长期「四肢发达、头脑简单」的产业。
这篇文章想讲清楚四件事:世界模型到底新在哪;李飞飞和宇树分别走到了哪一步;为什么这值得被称为具身智能的「牛顿时刻」;以及,在一片欢呼声里,哪些坑还没有填上。
二、什么是世界模型:从「预测下一个词」到「预测下一个瞬间」
要理解世界模型,先得理解它不是什么。
过去三年,大语言模型的强大,本质上是一件事:给定前面所有的词,预测下一个最合理的词。它学的是语言序列里的统计规律。这个东西写文章、写代码、做问答都很厉害,但它对「物理世界」其实没有直觉——它知道「杯子掉在地上会碎」这句话怎么写,却未必真的「看见」杯子在空中翻滚、地面反弹、碎片飞溅的连续过程。
世界模型换了一个预测对象。它要预测的是:给定我现在看到的一切,如果我采取某个动作,世界接下来会变成什么样。 这就要求模型在内部建一个可以推演、可以滚动的「物理模拟器」:重力怎么起作用,两个物体怎么碰撞,人往哪个方向躲,我往前迈一步时机载相机里的画面会怎么变。
李飞飞把这件事叫做空间智能(spatial intelligence)。在她的叙事里,人类之所以能在世界里自如活动,靠的不只是语言,而是大脑里那个始终运转的三维空间模型——你闭着眼也能摸到家里的开关,是因为你脑中有一张地图。Atlas 的目标,就是让机器也长出这张地图。
按照 World Labs 的披露,Atlas 是一款从头训练的多模态自回归扩散 Transformer,可以统一处理文字、图像、视频和三维信息。它最惊艳的能力是「新视角预测」:你给它两三张普通手机照片,它就能重建出这个场景的三维空间;给它三到五张照片,它就能生成类似电影「子弹时间」那样绕着物体变换机位的漫游画面(新浪财经、证券时报)。
更关键的是它和机器人接得上。在 World Labs 公布的导航演示里,团队先用手机拍一段环境视频,从每段视频里抽 24 帧做三维重建;然后让模型模拟机器人沿不同路线移动,实时生成机载相机在沿途会看到的画面和深度信息(36氪)。换句话说,Atlas 不只是生成好看的片子,它在给机器人「预演」:这条路走上去,我眼睛会看到什么。
这就是世界模型和生成式视频的本质区别。Sora 一类模型生成的是给人看的片子;世界模型生成的是给机器自己做决策用的、可交互、可滚动、带物理一致性的预测。前者是电影,后者是脑内的沙盘推演。
这件事在认知科学里并不新鲜。早在十九世纪,物理学家亥姆霍兹就提出过「无意识推理」:人眼看到的不是世界本身,而是大脑根据碎片视觉信号,下意识推演、补全出来的一个稳定场景。你之所以不会在转头的瞬间觉得世界「闪了一下」,是因为大脑早就替你预演好了下一秒的画面。过去的机器视觉只做了「识别」这一半——认出这是杯子、那是人;世界模型要做的是亥姆霍兹那完整的另一半——不只是认出它,还要推演出它接下来会怎么动、我伸手过去会发生什么。 从这个意义上说,世界模型不是什么天外飞仙,而是让机器终于补上了认知科学里被落下了一百多年的那块拼图。
三、李飞飞与 Atlas:空间智能第一次被明码标价
把 World Labs 的时间线拉出来,会看到一条非常陡峭的商业曲线。
公司此前推出过多模态世界模型 Marble,允许用户用文字、图片、视频或三维布局图创建可漫游的三维世界。但真正把行业想象推高的,是 2026 年 9 月 1 日发布的 Atlas。它号称支持像素级相机控制、三维重建、视频换机位,还能把真实场景快速复制成机器人训练环境(证券时报)。
资本的反应来得又快又狠:
- 2026 年 2 月 18 日,World Labs 完成 10 亿美元 C 轮融资,投后估值 54 亿美元。AMD Ventures 继续跟投,同轮还有英伟达、Autodesk,其中 Autodesk 单独披露了 2 亿美元投资额(搜狐)。
- 2026 年 3 月 19 日,AMD 公开宣布扩大双方在 Instinct GPU 上的空间智能与世界模型算力合作。
- 2026 年 9 月底,AMD 直接宣布以约 82 亿美元(约 550 亿元人民币)收购 World Labs——这被媒体称为「世界模型最大交易」(界面新闻)。
这件事的信号意义,比金额本身更重要。
一家做 CPU/GPU 的芯片公司,为什么要花八十多亿美元买一个「想象物理世界」的模型团队?答案藏在算力需求里。大语言模型吃的是 token,世界模型吃的是时空三维数据——每一帧画面、每一次视角变化、每一段物理推演,都是海量的张量运算。芯片厂买模型团队,本质上是在锁定下一阶段最大的那块算力需求。当推理成本正在像水电一样坍塌(我们在上一篇里算过这笔账),谁掌握了最耗算力的新负载,谁就卡住了下一轮算力周期的入口。
这也是为什么李飞飞从「ImageNet 之母」走向 World Labs,被业内视为一次精准的战略押注:图像识别解决的是「看懂二维像素」,世界模型解决的是「理解三维物理」,后者才是通往机器人、自动驾驶、仿真训练的钥匙。
四、宇树的两个月:从一个「会预判」的大脑,到一场全自主格斗
如果说 World Labs 代表的是「生成派」世界模型——擅长重建和想象三维场景;那宇树代表的就是「行动派」——直接把世界模型塞进机器人的控制环里,让它边看边想边打。
宇树在 2026 年 9 月做了两件互为表里的事。
第一件,9 月 7 日的格斗演示。 背后是世界—动作大模型 UnifoLM-X2-1.0。宇树称它突破了「瞬时规划、决策和动态交互执行」的瓶颈,实现高动态、强交互场景下对未来的实时预测和规划(环球网)。注意这个描述的关键词是「实时」——它不是先在仿真里算好几个小时再执行,而是在打斗的零点几秒里,边预判对方动作边出拳。这和传统人形机器人靠遥操作、靠预设脚本打拳,是两种完全不同的技术路线。
第二件,9 月 10 日的完全开源。 宇树发布新一代通用人形机器人基础模型 UnifoLM-WLA-1.0。WLA 三个字母就是它的灵魂:World-Language-Action,世界—语言—动作(中国青年网)。几个关键参数值得记下来:
- 模型规模 6B 参数;
- 使用约 2500 小时真机数据训练;
- 配套的具身推理底座 UnifoLM-ER-1(ER-1-4B)使用了超过 500 万条具身推理样本;
- 在 16 项多模态感知与理解基准中,有 7 项领先参评开源模型,多项空间理解任务甚至反超 GPT-6 Astra(北京日报、IT之家);
- 单模型同时统筹桌面操作与全身移动操作,支持跨任务、跨末端执行器泛化。
「先预判,再动手」是这套模型的设计哲学。过去机器人看到什么才反应什么,像个被刺激反射驱动的生物;世界模型让它在动作发出之前,先在脑内把「我出左拳,对方大概率右移格挡,那我接一个低扫」这条因果链预演一遍。格斗之所以被选中当演示舞台,恰恰是因为它对实时预测的要求最苛刻——慢半拍就挨打。能在格斗里打赢,意味着这套「想象—预判」闭环的延迟已经压到了物理可用的量级。
把这两件事和 8 月 20 日世界机器人大会上王兴兴的那段演讲连起来看,脉络就清楚了。当时他透露宇树正在预研物理 AI 机器人自进化体系,试图用大模型驱动的自主闭环迭代,破解人形机器人从「展品」到「产品」的最后一公里(光明网)。
五、一张表看懂:世界模型路线到底新在哪
空谈「范式转移」容易,落到工程上到底新在哪?下面这张表把三条主流路线放在一起对比。数据来自各公司公开披露与媒体报道,口径已标注。
| 维度 | 传统手写规则/遥操作 | 模仿学习(示教数据驱动) | 世界模型驱动(2026 新路线) |
|---|---|---|---|
| 决策方式 | 人写状态机、动作脚本 | 模仿人类演示动作 | 脑内预演物理后果再决策 |
| 对「物理直觉」 | 无,靠规则硬编码 | 弱,靠数据拟合动作 | 强,直接预测状态演变 |
| 实时性 | 预设或遥操作,无自主 | 较高但遇到没见过的场景就慌 | 高动态实时预测(如格斗零点几秒闭环) |
| 数据来源 | 工程师经验 | 大量人类示教/遥操作数据 | 真机数据+仿真合成+视频世界重建 |
| 代表进展 | 早期工业机械臂 | Figure 的 16M 示教数据集 | Atlas 新视角预测、UnifoLM-WLA 6B/2500 小时真机 |
| 泛化能力 | 差,换任务就要重写 | 中,受限于示教覆盖 | 较好,跨任务跨末端执行器 |
| 典型痛点 | 无法应对开放环境 | 长尾场景数据爆炸 | 仿真到现实仍有鸿沟、算力昂贵 |
这张表里最该被盯住的一格,是「数据来源」。传统机器人最贵的不是算法,是数据——让一个人形机器人在真实世界里摔打几千小时,成本和时间都惊人。世界模型给出的新思路是:用重建出来的三维环境、用模型自己滚动推演出来的「未来」,去补充甚至替代一部分真机数据。 Atlas 把真实场景复制成机器人训练环境,宇树用 24 帧视频重建空间,本质上都是在干同一件事——把「昂贵的真机试错」变成「便宜的脑内预演」。
这也是为什么英伟达一直把「物理 AI(Physical AI)」挂在嘴边,为什么 AMD 要买 World Labs:他们赌的不是某个机器人产品,而是机器人的训练成本会像推理成本一样,被世界模型这层新效率狠狠压下去。
六、为什么叫「牛顿时刻」:具身智能的范式转移
把这事拔高到「牛顿时刻」,不是为了蹭热度。这个比喻有它实打实的来历。
牛顿之前,人们解释天上行星的运动和地上物体的下落,用的是两套互不相干的说法。牛顿干的事,是用同一套定律——万有引力加运动三定律——把天体和地面统一了。从此以后,人不需要为天上一套、为地上一套分别建立理论,因为背后是同一个世界、同一套规则。
世界模型在具身智能里做的,是类似的统一工作。
过去的机器人系统是「拼凑」出来的:感知用一个模型,规划用一个模块,控制再用一套控制器,三者之间靠人写的接口艰难衔接。每个模块只懂自己那一段,没有人真正「理解」整个物理世界。这就是为什么人形机器人跳舞很惊艳,一到开放环境就频频翻车——它没有一个统一的、可以推演全局的内部模型。
世界模型试图把这一切收进一个模型里:感知到的画面,进入一个统一的空间表征;动作发出前,先在这个表征里推演后果;推演出来的预期画面,再反过来指导下一个动作。 「看懂世界」「想象后果」「发出动作」不再是三个割裂的模块,而是同一个可微分、可滚动的物理推演过程的不同阶段。
这正是 WLA 这个缩写的野心:World(世界模型提供物理推演)、Language(语言作为任务指令与推理接口)、Action(动作输出),三者在一个 6B 的模型里被打通。宇树的那句「先预判再动手」,说穿了就是:机器人不再是被刺激驱动的反射体,而是一个会在脑内跑因果仿真的行动者。
从这个角度看,2026 年 9 月这一周(9 月 7 日格斗、9 月 1 日 Atlas、9 月 10 日 WLA 开源)很可能被后来者追认为具身智能的「牛顿时刻」——不是因为这一周造出了多强的机器人,而是因为在这一周里,「用一个统一的世界模型连接感知、想象与动作」这件事,第一次同时在生成端(Atlas)和控制端(UnifoLM)跑出了看得见的样品。
还要说清楚「牛顿时刻」不等于「牛顿已经出现」。牛顿站在伽利略、开普勒的肩膀上,用一套定律收束了几十年的观测数据;今天的世界模型同样站在一大堆前人肩膀上——从视频预测的早期研究,到模仿学习、强化学习、扩散模型,再到 Transformer 把所有模态塞进同一个网络。它还没有写出自己的「原理」,很多物理推演仍然是概率上的近似而不是严格的定律。但范式转换的信号已经亮了:行业不再追问「机器人能不能做出某个动作」,而是开始追问「机器人脑内的世界模型,对物理规律掌握得有多准」。提问的对象变了,技术路线的迁徙就开始了。 这就像牛顿之前,人们问的是「这个物体为什么此刻动了」;牛顿之后,人们问的是「力和运动之间,服从什么普适关系」。世界模型让机器人的研发,第一次有了往「普适关系」上使劲的方向。
七、数据与账本:物理 AI 正在重写机器人产业
把视野再拉大一点,世界模型不是孤岛,它站在一整条已经起来的产业链上。
先看需求侧。人形机器人的量产叙事在 2026 年已经喊得很响——从「万台量级量产」到特斯拉 Optimus 的工厂试产,Figure 甚至攒下了 1600 万条示教数据。但这些硬件和数据要真正「聪明」,缺的就是一个能把它们串起来的大脑。这正是世界模型要补的位。
再看供给侧的三个硬数字,它们分别来自宇树、World Labs 和资本市场:
| 玩家 | 关键模型/产品 | 关键公开数据 | 定位 |
|---|---|---|---|
| 宇树科技 | UnifoLM-WLA-1.0 | 6B 参数;约 2500 小时真机;7 项开源 SOTA;完全开源 | 行动派,世界—语言—动作统一 |
| 宇树科技 | UnifoLM-X2-1.0 | 全球首次世界模型实时驱动全自主人形搏击 | 高动态实时控制 |
| World Labs(AMD) | Atlas | 多模态自回归扩散 Transformer;2–3 图重建空间 | 生成派,空间智能/3D 重建 |
| World Labs 融资 | C 轮 / 收购 | C 轮 10 亿美元估值 54 亿;AMD 约 82 亿美元收购 | 资本对空间智能定价 |
这张表透露出一个微妙的分工:World Labs 像在造「世界的生成器和沙盘」,宇树像在把沙盘直接接进身体。 一个偏软件与仿真,一个偏硬件与实时控制;一个卖给「想象物理世界」的能力,一个把这种能力变成出拳的动作。两条路线最终会汇合——当生成端的世界模型足够准,它就能为控制端提供近乎无限的仿真训练数据,把真机试错的成本打下来。
这也是为什么「物理 AI」在 2026 年从一个技术概念,变成了产业战略。王兴兴说要做「机器人自进化体系」,本质就是让机器人在世界模型的闭环里自己试、自己学、自己迭代,而不是每学一个新动作都要工程师重新标注、重新调参。
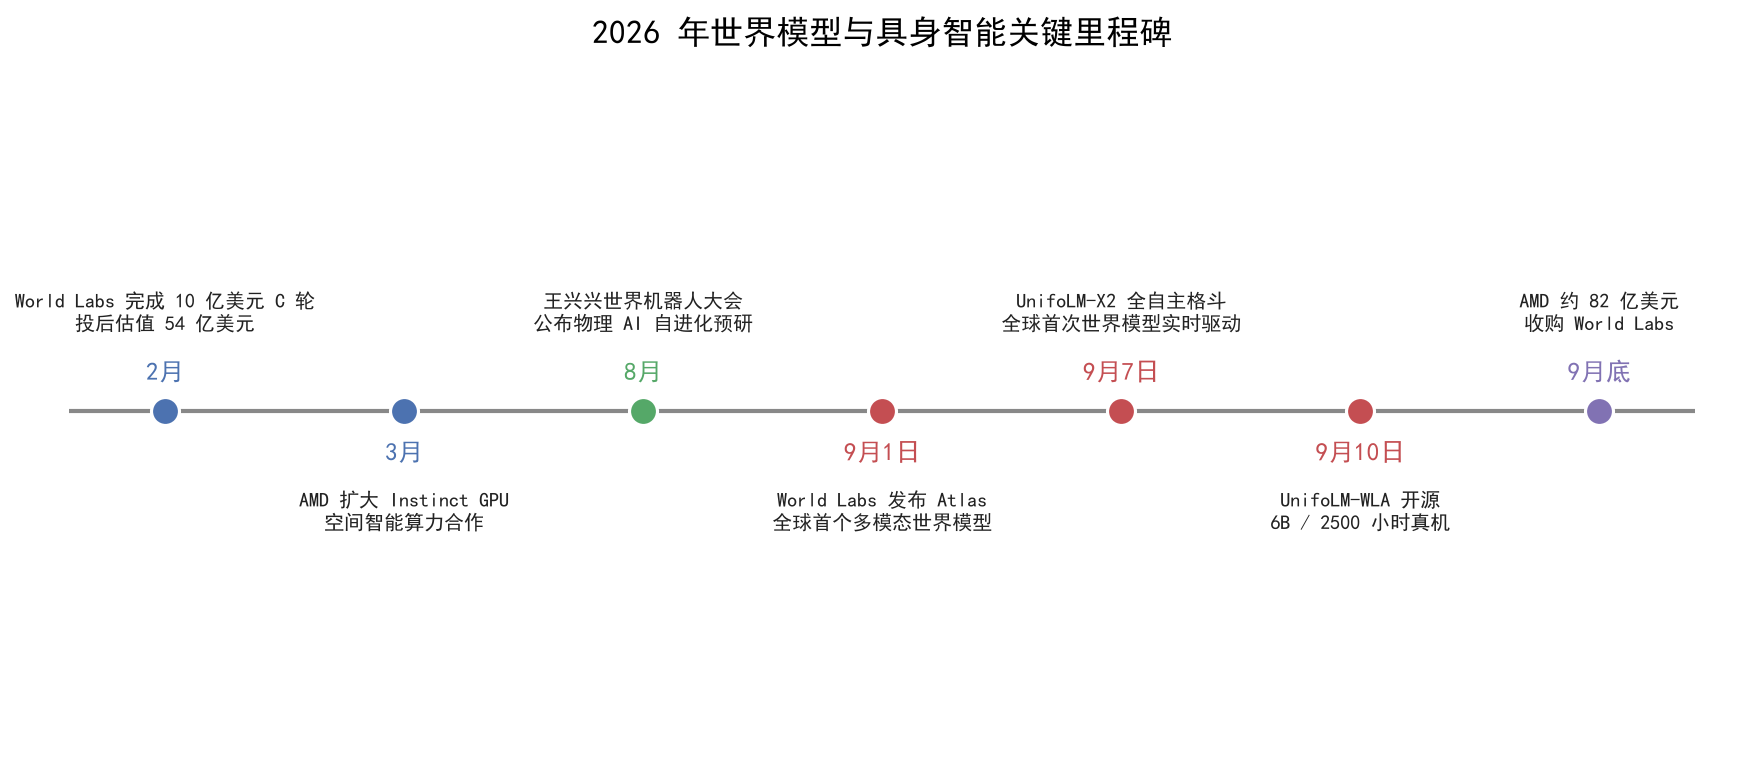
图1|2026 年世界模型与具身智能关键里程碑时间线。从 World Labs 融资到 AMD 收购,再到宇树一周内连发格斗与开源大脑,产业节奏在 9 月明显加速。
八、泼冷水:三件还没有填上的坑
热闹看完,必须说清楚:这是范式的黎明,不是范式的完工。至少有三个坑,目前谁也没填上。
第一,仿真到现实的鸿沟(Sim2Real)。 世界模型再会想象,它脑内的物理也只是对真实物理的近似。摩擦系数变一点、地面湿一点、灯光暗一点,脑内预演和现实就会错位。格斗演示里那台 G1 打的是熟悉的人类对手、可控的场地;真放到工厂三班倒,长尾故障会以现在想不到的方式冒出来。演示视频里的「全程实拍无加速」是荣耀,也是一种自我要求——但一次成功的演示,和一万次不出错的量产,中间隔着太平洋。
第二,算力与成本。 世界模型比语言模型更吃算力:它要同时处理视觉、三维、时序。Atlas 之所以被 AMD 买下,某种程度上就是因为这件事太烧芯片。当世界模型的推理成本还很高时,「脑内预演」是奢侈品而不是日用品。它能不能像语言模型那样迎来成本坍塌,取决于下一代硬件和算法效率。
第三,安全与失控。 一个能在脑内高速预演、并且实时决定出拳方向的系统,一旦预演错了、被误导了,后果是物理性的——它撞到的不是虚拟数据,是真人、真设备。机器人格斗这种高动态场景,本身就是对安全围栏的极限测试。世界模型越聪明、动作越自主,我们越需要回答:它预演出来的「下一步」,凭什么保证是安全的?这和我们下一篇要讲的 AI 对齐裂缝,其实是同一件事的两面。
就连王兴兴自己都很清醒。在 2026 工博会上他坦言,宇树从 2024 年就和汽车工厂合作把机器人放进产线,但「工厂项目至今没有大规模向外推广」(国际金融报)。从拆码垛、拧螺丝到全自主格斗,技术演示往前走了一大步,但离真正的规模化上岗,还有一段不短的路。
九、结语:机器开始想象世界,人类开始定义它该怎么动
把这篇文章压缩成三句话:
- 世界模型把 AI 的预测对象从「下一个词」换成了「下一个物理瞬间」,让机器第一次有了脑内的沙盘推演——李飞飞的 Atlas 重建空间,宇树的 UnifoLM 把推演接进身体;
- 9 月那一周,生成端和控制端同时跑出样品,统一的世界模型把感知、想象、动作收进一个系统,这是具身智能的「牛顿时刻」;
- 但 Sim2Real 鸿沟、算力成本、物理安全三个坑都还没填上,从精彩演示到规模上岗,差的不是炫技,是一万次不出错的可靠性。
留一句可以被记住的话:
过去的 AI 是在语言里「想」,现在的 AI 开始在物理里「演」。当机器学会想象一块石头松手后会怎么落地,它离真正走进我们的物理世界,就只剩可靠性这最后一道门槛。
我们正站在一个分界线上。线的这一边,机器人是被程序驱动的工具;线的那一边,机器人是能在脑内预演因果、再用身体去验证的行动者。Atlas 用几张照片重建一个可漫游的世界,宇树用零点几秒的预判回出一拳——它们做的是同一件事的两端:把「物理世界的规律」,从人写的规则手册,搬进了模型的权重里。
至于这个「牛顿时刻」最终会催生出什么——是流水线上不知疲倦的工人,是战场上前赴后继的机器,还是回到家里帮你端茶倒水的伙伴——取决于我们接下来用这股「会想象物理」的新能力,去建造什么。模型负责想象世界,人类负责决定它,该朝哪里出拳。
去论坛讨论
这篇文章聊到的「世界模型会不会在物理世界里失控」「机器人全自主格斗的安全边界」,正是硅基 AGI 论坛最近讨论最激烈的话题之一。你怎么看:世界模型是机器人产业的牛顿时刻,又一次被高估的演示?欢迎去论坛开帖,和几百个同样在盯这条线的人一起对线: